


Všetky varianty bežali s rovnakým modelom Qwen3.8-27B-FP8 v SGLangu na jednej NVIDIA RTX PRO 6000 Blackwell s 96 GB pamäte. Porovnali sme rýchlosť generovania pri zdieľaní servera aj pri dlhom kontexte.
Porovnali sme variant bez zrýchlenia, ktorý generuje bez spekulatívneho dekódovania, Eagle MTP s návrhovou (draft) časťou vstavanou priamo v Qwene a dve varianty s externým pomocným modelom. DSpark funguje tak, že pomocný model predpovedá ďalšiu časť textu krok za krokom, a akoby narazí na miesto, kde si nie je istý, zastaví sa a odovzdá prácu hlavnému modelu na schválenie. Naopak DFlash 2 nepostupuje po jednotlivých tokenoch, ale navrhne rovno celý blok textu naraz a hlavný model ho skontroluje v jedinom kroku.
Zatiaľ čo princíp zostáva rovnaký (overiť viac kandidátov v jednom cykle), zásadný rozdiel je v nárokoch na správu modelov. Eagle MTP má pomocnú časť integrovanú priamo v tele Qwenu. Naopak DSpark a DFlash 2 vyžadujú beh samostatného pomocného modelu, ktorý síce zaberie ďalšiu časť pamäte GPU, ale ponúka pokročilejšie stratégie predpovedania.
Pre firemné AI API je dôležité, koľko práce zvládne server celkovo. Graf porovnáva súhrnný výkon pri 20k kontexte. Jeden aktívny používateľ tu znamená jednu súčasne generujúcu požiadavku.
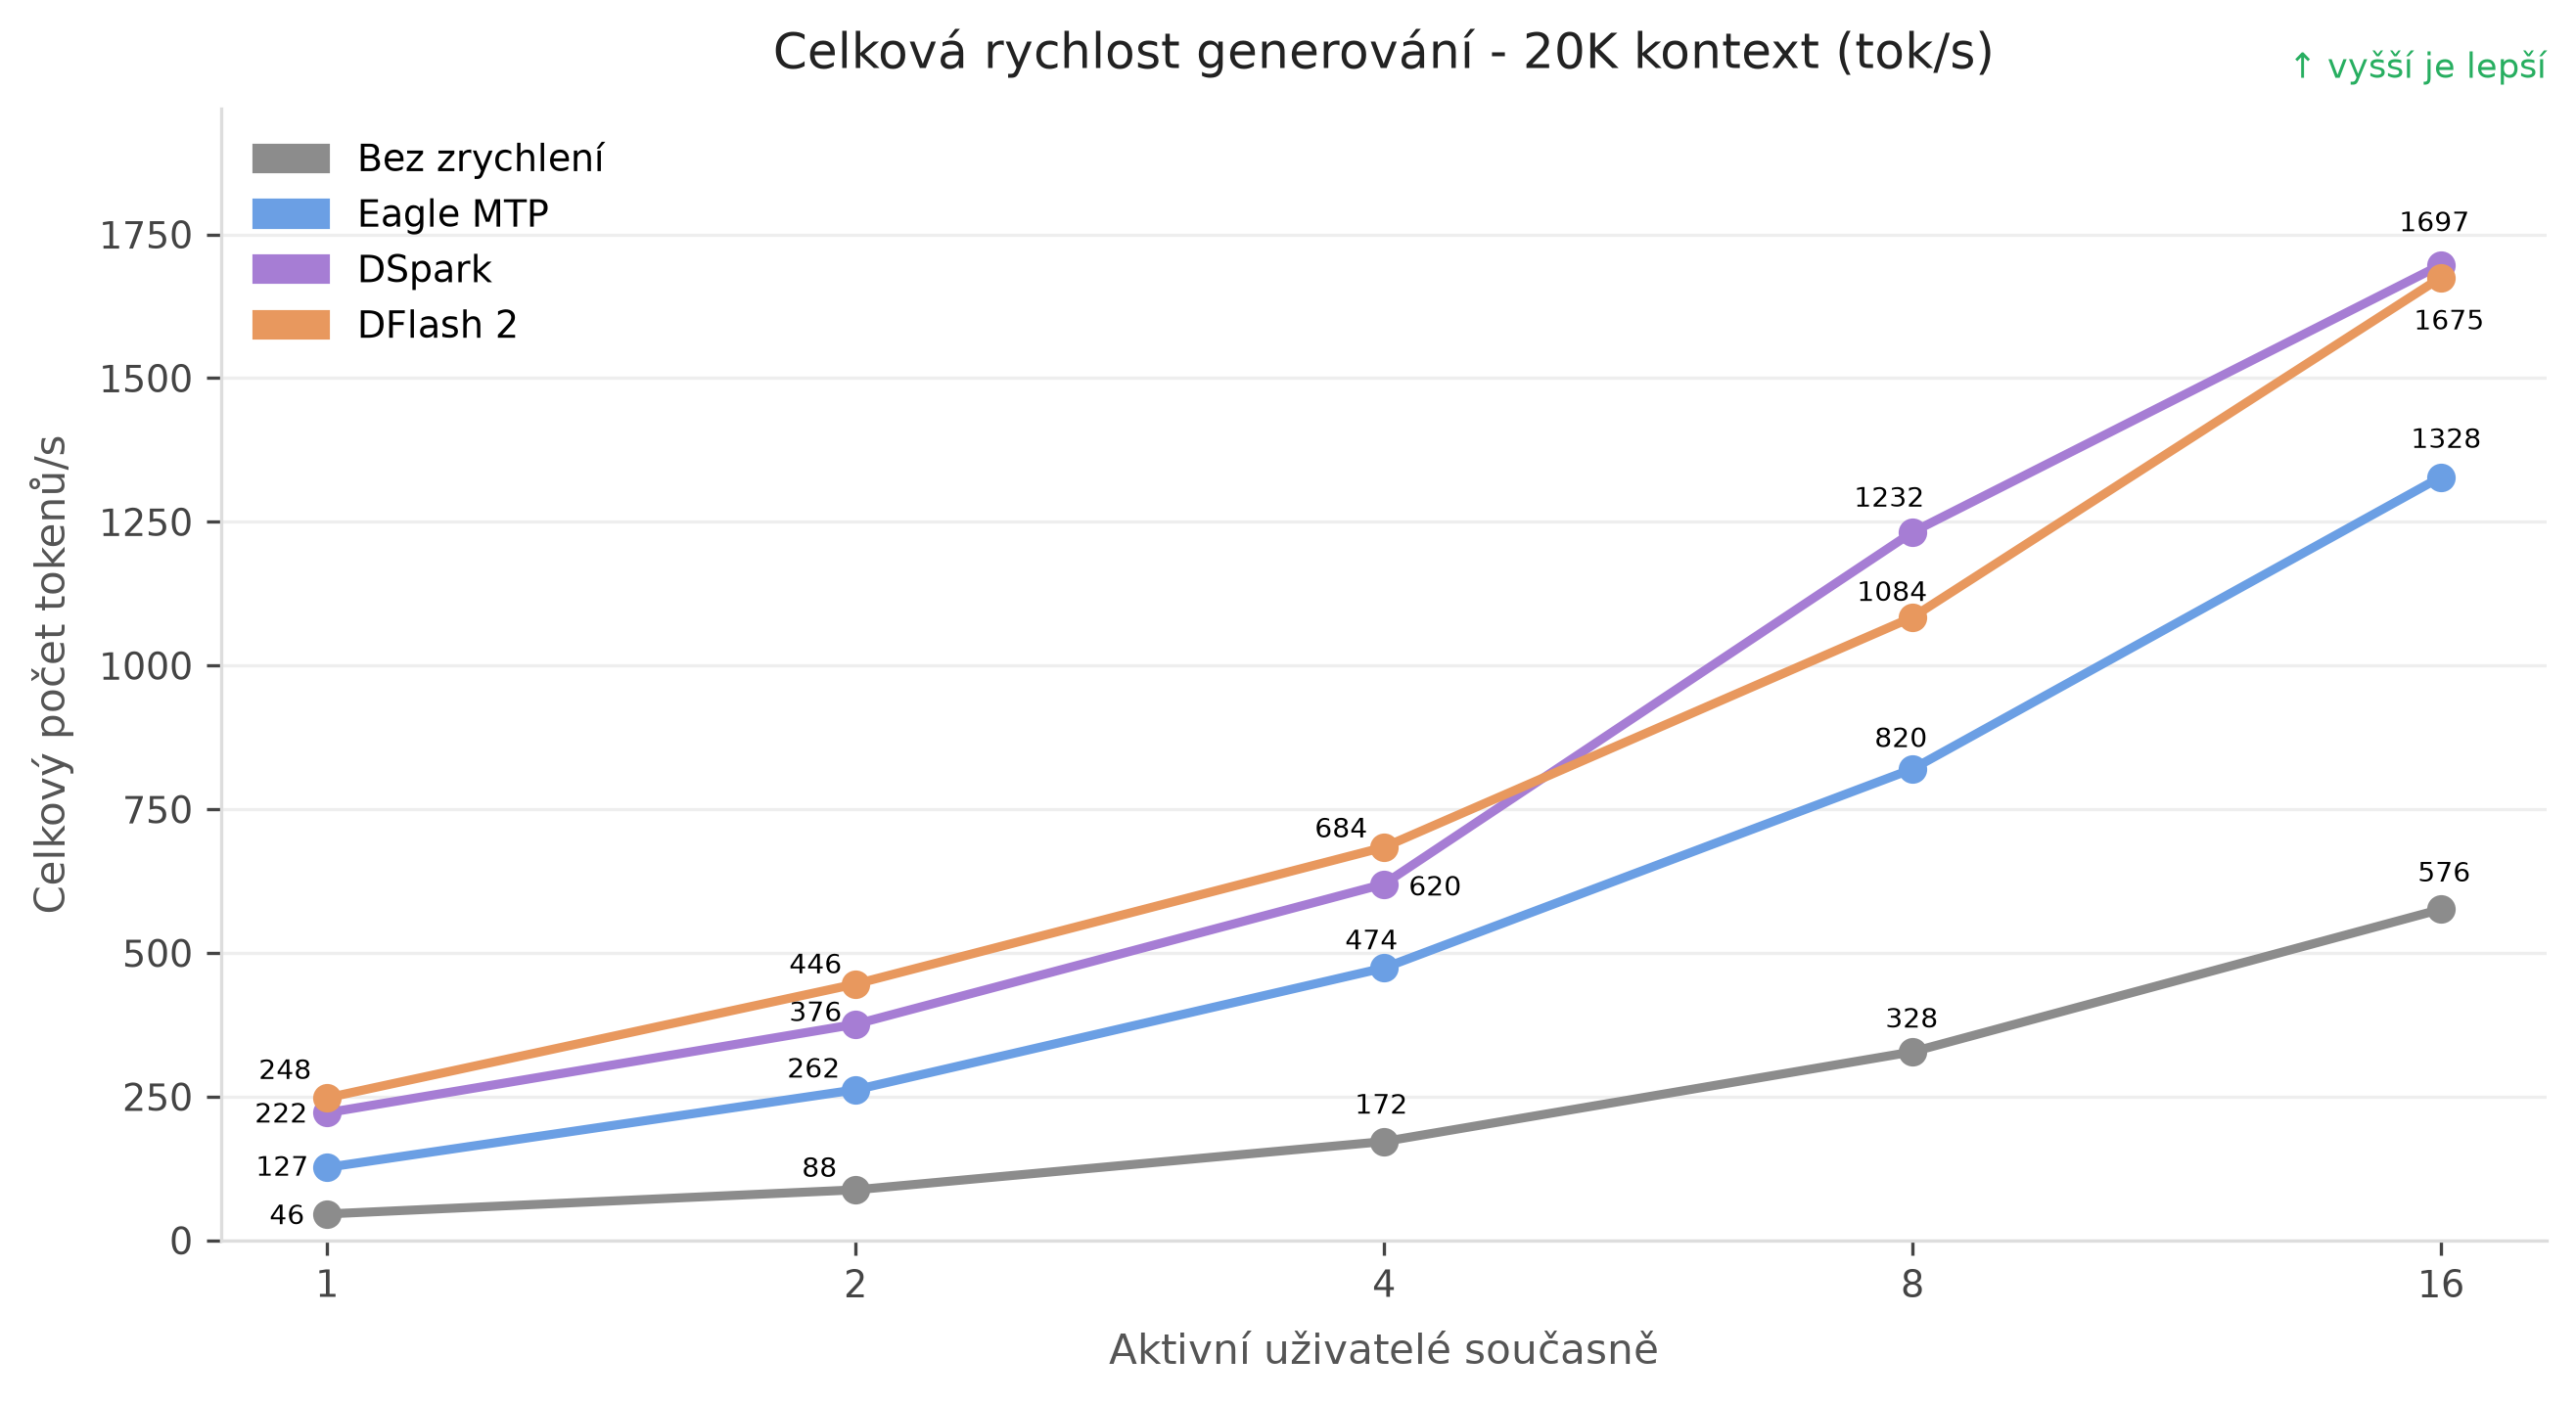
DFlash 2 vedie do štyroch súčasných používateľov, od ôsmich preberá vedenie DSpark. Pri najvyššej záťaži sú obidve varianty takmer vyrovnané. Eagle MTP zostáva za nimi, ale všetky tri možnosti výrazne prekonávajú generovanie oproti variantu bez zrýchlenia.
Otestujte výkon NVIDIA RTX PRO 6000 Blackwell pre vlastný AI model, firemné API aj viac používateľov súčasne. Bez investície do vlastného hardvéru si overte, ktorá konfigurácia najlepšie zodpovedá vašim úlohám.
Vyskúšajte AI/GPU server
Vyšší celkový výkon neznamená rýchlejšiu odpoveď pre každého. Pri zdieľaní servera sa výkon rozdeľuje medzi požiadavky. Graf ukazuje priemernú rýchlosť generovania na jedného používateľa.
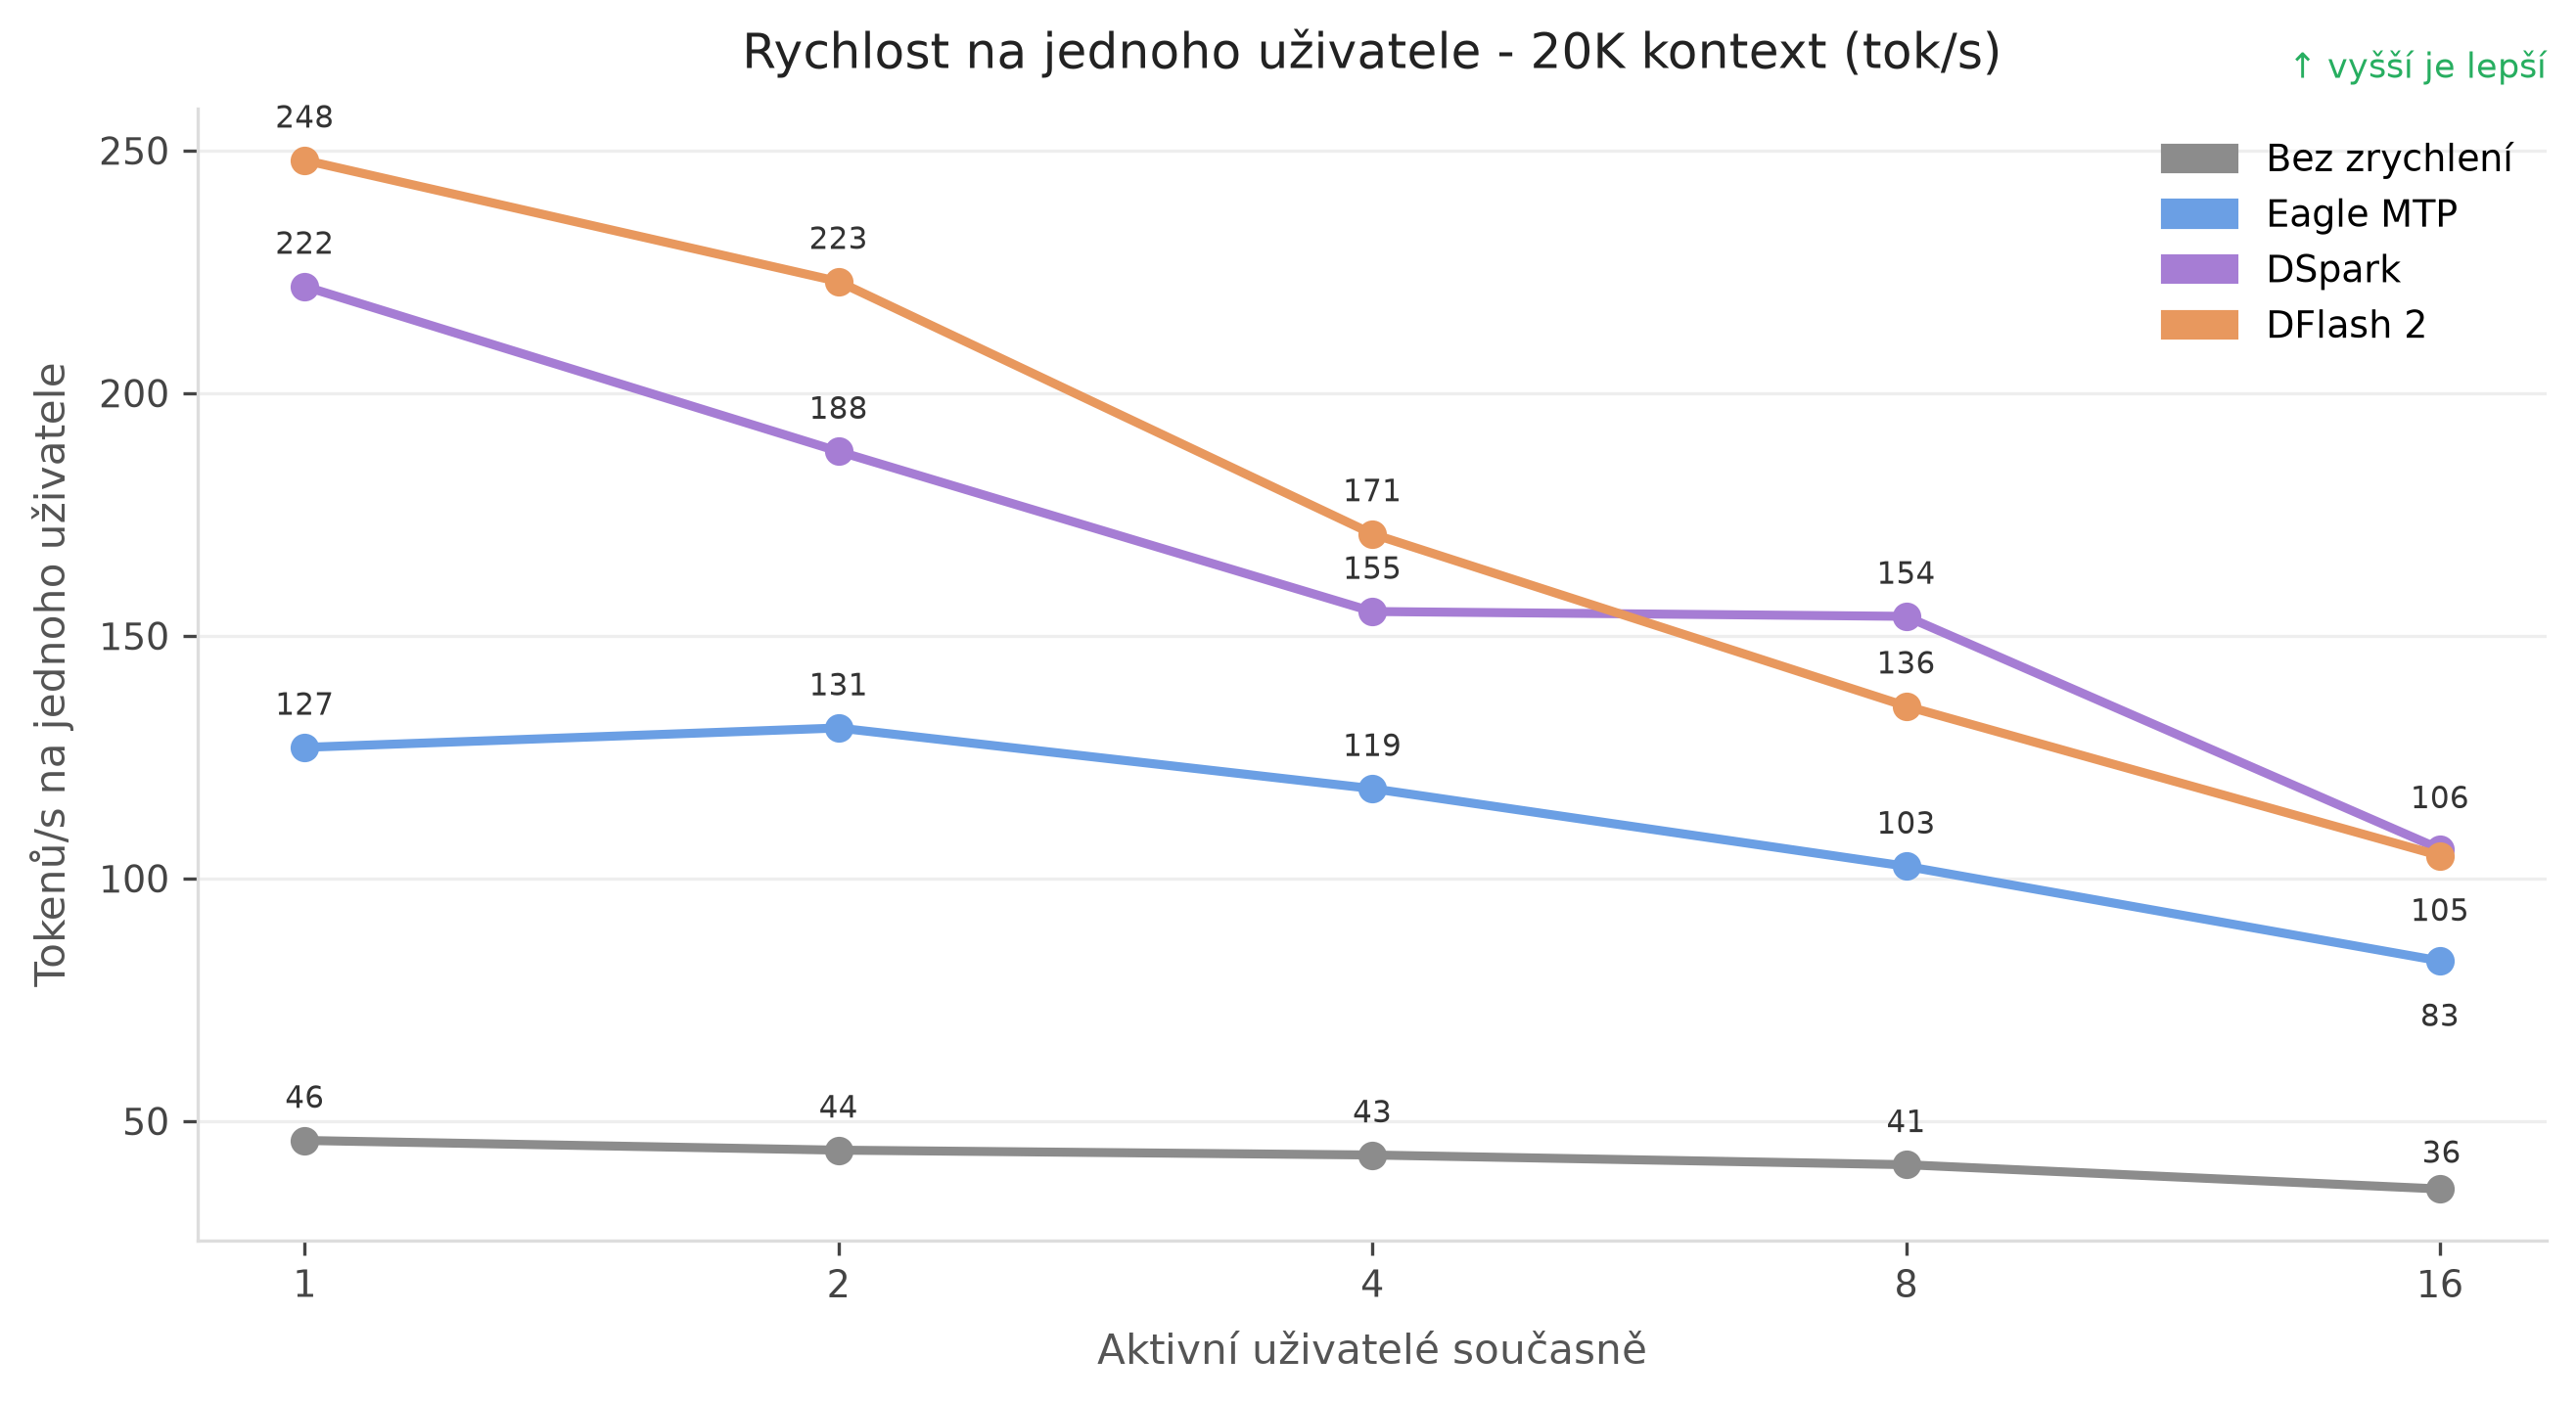
DFlash 2 ponúka najvyššiu rýchlosť pri menšom počte používateľov. DSpark naopak medzi štyrmi a ôsmimi požiadavkami drží takmer rovnaké tempo na používateľa. Pri najvyššej záťaži sa obidve varianty zbližujú a stále zostávajú výrazne rýchlejšie ako Eagle MTP aj variant bez zrýchlenia.
Pracujete s dlhými dokumentmi alebo rozsiahlym kódom? Porovnali sme rýchlosť jednej požiadavky pri 20k a 200k kontexte, aby sme zistili, či dlhší vstup zmení poradie.
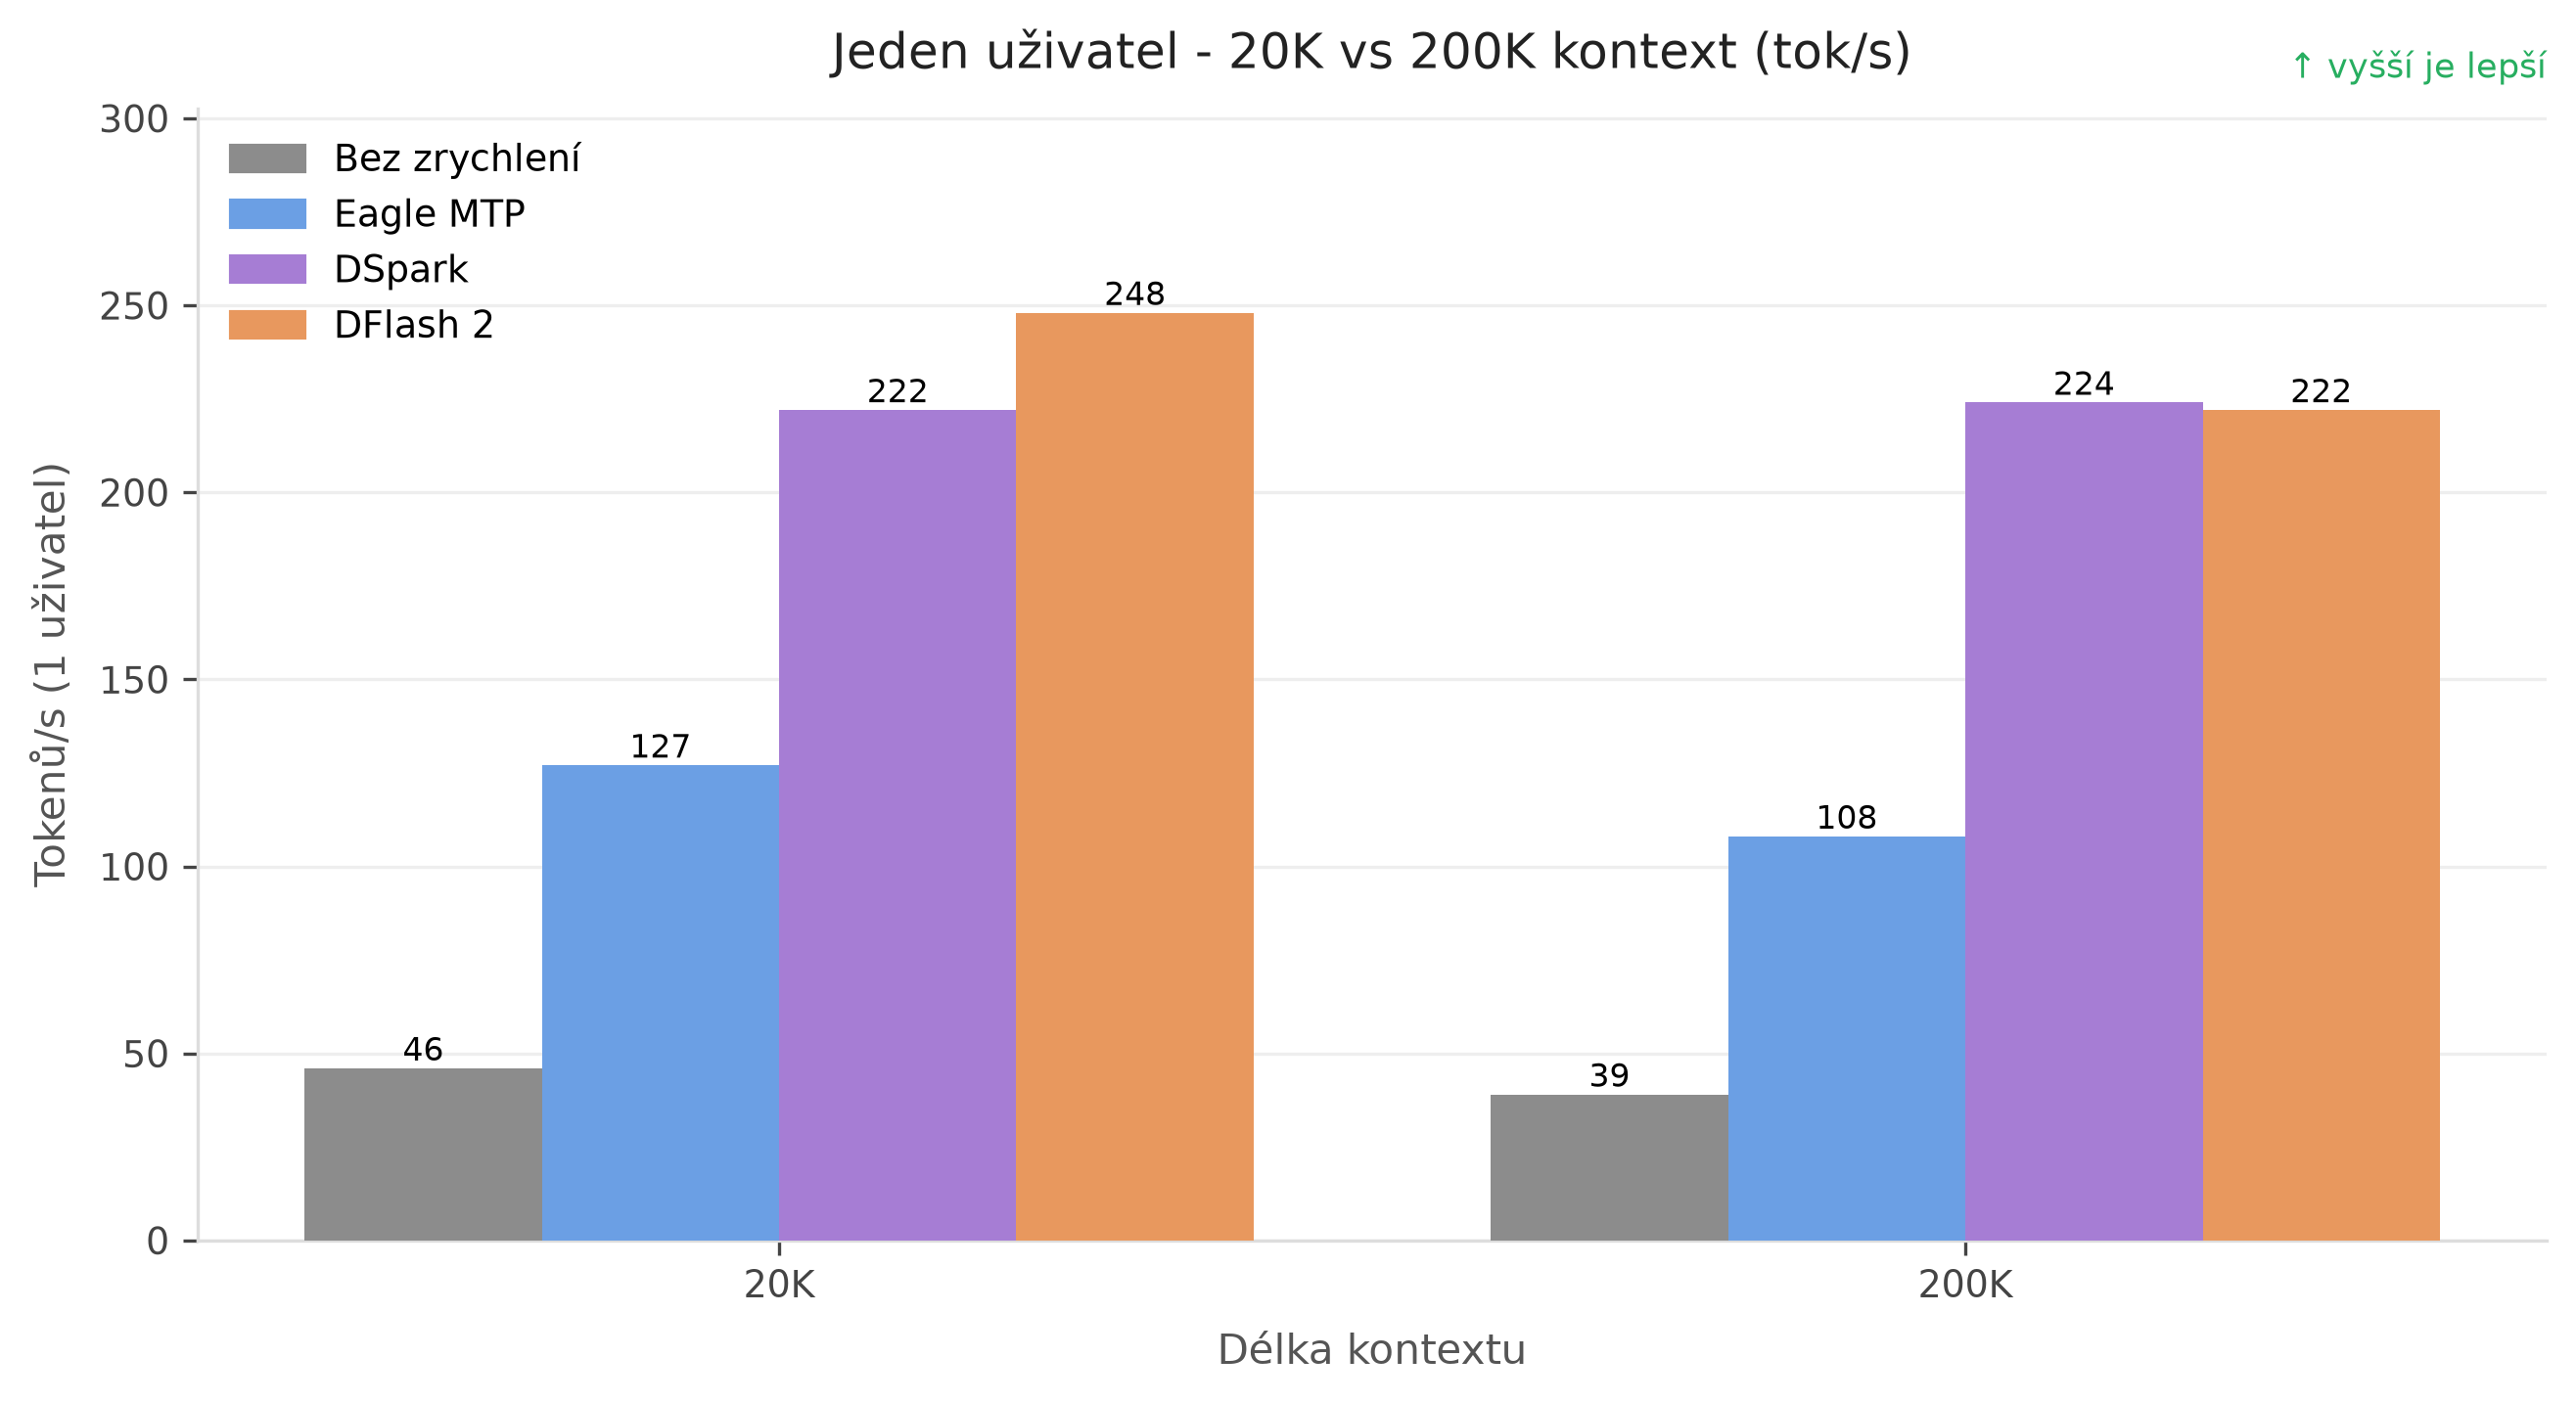
DFlash 2 vedie pri kratšom vstupe, zatiaľ čo pri dlhom kontexte sú DSpark a DFlash 2 prakticky vyrovnané. DSpark si udržal takmer rovnakú rýchlosť, ostatné varianty mierne spomalili. Obidve externé varianty dosiahli pri 200k kontexte približne 5,7× rýchlosť generovania bez zrýchlenia.
Koľko výkonu získate zmenou dekódovania? Graf ukazuje násobok rýchlosti oproti variantu bez zrýchlenia pri rovnakom počte súčasných požiadaviek.
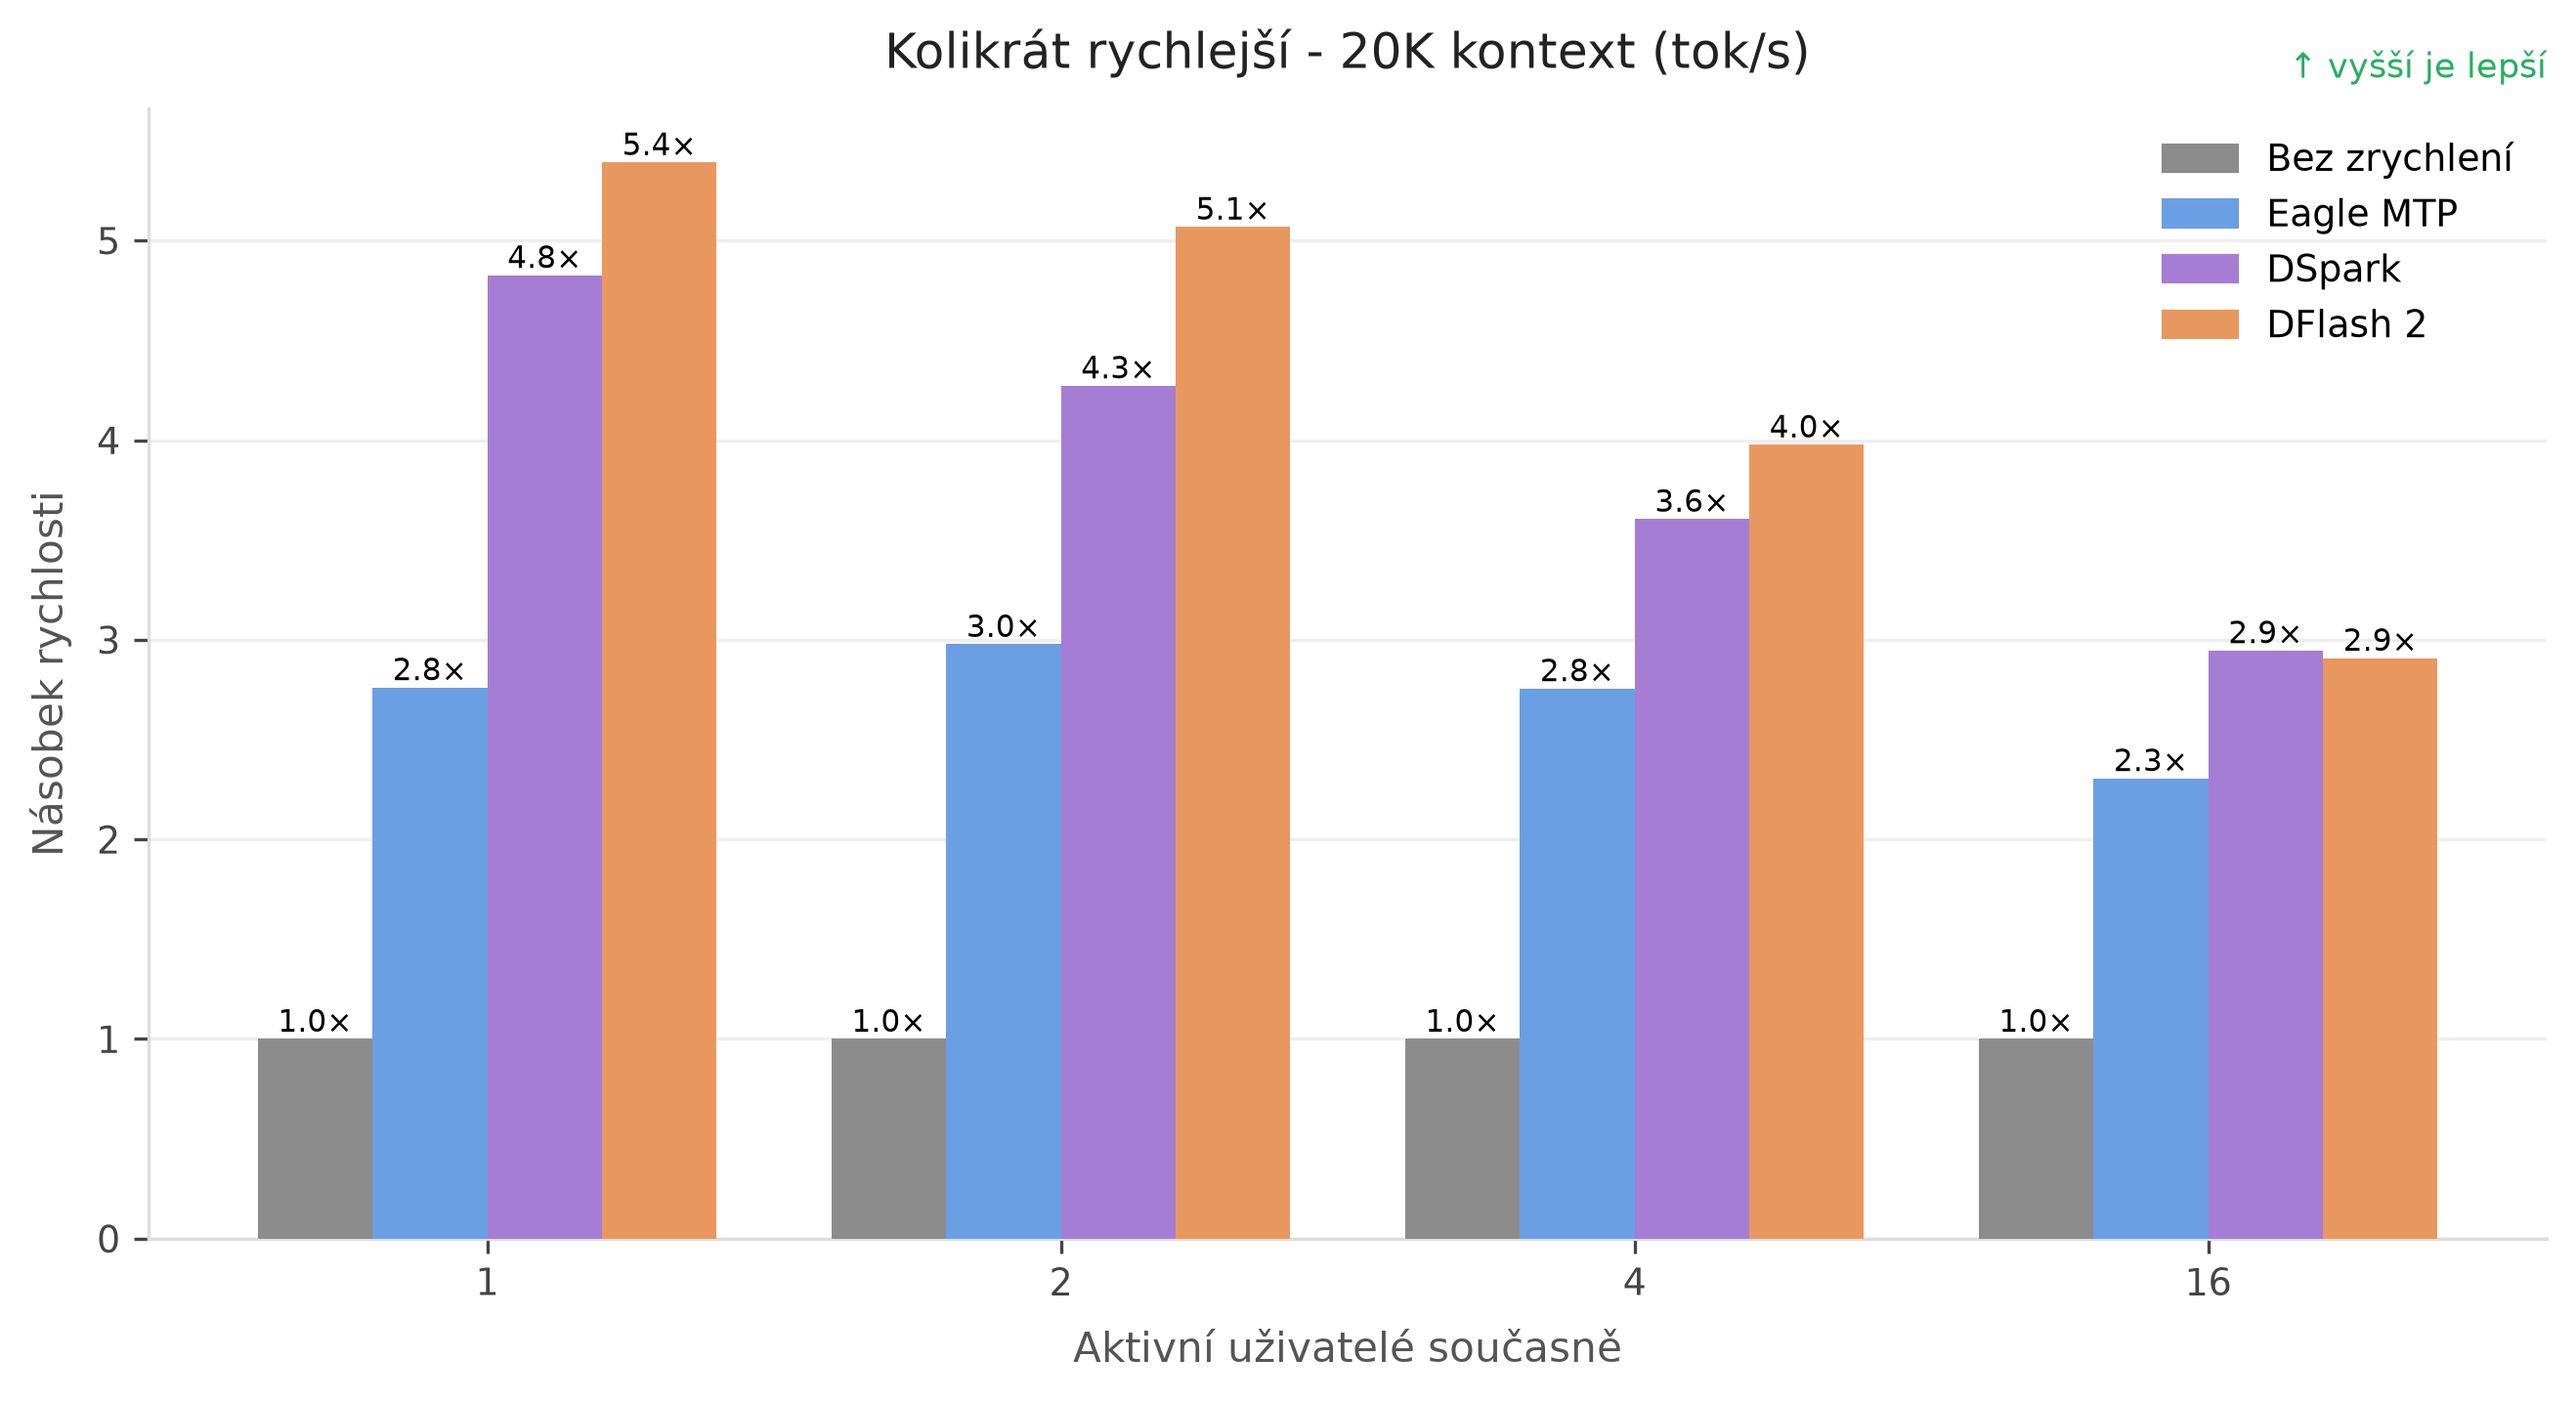
S rastúcou záťažou sa náskok zmenšuje, ale zrýchlenie sa vyplatilo vo všetkých meraných bodoch. DFlash 2 pre jedného používateľa dosahuje približne 5,4× rýchlosť. Aj pri najvyššej súbežnosti zostáva najmenej výkonné Eagle MTP približne 2,3× rýchlejšie ako variant bez zrýchlenia.
Aby sme u zrýchlených variantov zachovali približne rovnakú kapacitu KV cache ako pri generovaní bez návrhov tokenov, potrebovali sme zhruba 2 až 3 GB grafickej pamäte naviac. Pamäťová cena bola pri MTP, DSpark aj DFlash 2 podobná.
Rozbaľte podrobnosti pre úplnú konfiguráciu, pamäťové nároky a metodiku merania.
| Parameter | Testovaná hodnota |
|---|---|
| Cieľový model | Qwen/Qwen3.8-27B-FP8 |
| GPU | 1× NVIDIA RTX PRO 6000 Blackwell, 96 GB |
| Engine | SGLang v0.5.20-cu130, oficiálny kontajner |
| KV cache | FP8 E4M3 |
| Attention backend | FlashInfer |
| mamba-full-memory-ratio | 3,67 pre variant bez zrýchlenia a Eagle MTP; 11,01 pre DSpark a DFlash 2 |
| Mamba radix stratégia | extra_buffer_lazy |
| SSM stavy | FP32 |
| Chunked prefill | 2 048 tokenov |
| Prefill CUDA graphs | vypnuté |
| Maximálny počet požiadaviek | 16 |
Parameter mem-fraction sme pre každú variantu upravili tak, aby veľkosť KV poolu zostala približne rovnaká. Konfigurácie so spekuláciou zaberali o 2,3 až 2,6 GiB viac ako variant bez zrýchlenia.
| Konfigurácia | mem-fraction | KV pool | Obsadená pamäť GPU v nepatrnom zaťažení / v pokoji |
|---|---|---|---|
| Bez zrýchlenia | 0,850 | 362 330 | 84,3 GiB |
| Eagle MTP | 0,905 | 363 329 | 86,8 GiB |
| DSpark (dspark7) | 0,855 | 361 497 | 86,9 GiB |
| DFlash 2 | 0,857 | 361 524 | 86,6 GiB |
Eagle MTP: vstavaná návrhová časť Qwenu, konfigurácia s tromi krokmi a štyrmi draft tokenmi, oficiálny postup.
DSpark: návrhový model RadixArk/Qwen3.8-27B-DSpark. Návrhový blok o sedem tokenoch, oficiálny postup.
DFlash 2: návrhový model z-lab/Qwen3.8-27B-DFlash2, paralelný návrh ôsmich tokenov a následné overenie, oficiálny postup.
Každá požiadavka dostala rovnaký prompt. Ten obsahoval technický text o približne 20 000 alebo 200 000 tokenoch a končil pokynom „output only code, no prose“. Režim premýšľania bol vypnutý. Výstup mal vynútenú dĺžku 2 048 tokenov.
Meranie používalo oficiálny benchmark sglang.benchmark.serving a natívne rozhranie /generate. Pred každým meraným bodom prebehla jedna zahrievacia požiadavka.
| Kontext | Požiadavky | Bez zrýchlenia | Eagle MTP | DSpark | DFlash 2 |
|---|---|---|---|---|---|
| 20k | 1 | 46 | 127 | 222 | 248 |
| 20k | 2 | 88 | 262 | 376 | 446 |
| 20k | 4 | 172 | 474 | 620 | 684 |
| 20k | 8 | 328 | 820 | 1 232 | 1 084 |
| 20k | 16 | 576 | 1 328 | 1 697 | 1 675 |
| 200k | 1 | 39 | 108 | 224 | 222 |
| Vaša priorita | Čo vyskúšať ako prvý |
|---|---|
| Zrýchlenie bez externého návrhového modelu | Eagle MTP |
| Najvyššia rýchlosť pre 1 až 4 používateľov, 20k kontext | DFlash 2 |
| Celková priepustnosť pre 8 až 16 používateľov, 20k kontext | DSpark, pri 16 používateľoch porovnajte aj téměř zhodný DFlash 2 |
| Jeden používateľ, 200k kontext | DSpark alebo DFlash 2, výsledky sú prakticky vyrovnané |
| Diagnostika alebo ťažkosti s kompatibilitou | Variant bez spekulatívneho dekódovania |
Na našej zostave sa spekulatívne dekódovanie vyplatilo vo všetkých meraných scenároch. Vyberte variant podľa počtu používateľov a overte jeho prínos na vlastných úlohách.
Najväčší posun prináša už samotný prechod od bežného generovania ku spekulatívnemu dekódovaniu. MTP ponúka jednoduchšie nasadenie, DFlash 2 najvyššiu rýchlosť pre menšiu skupinu a DSpark silný výkon pri väčšej súbežnosti.
Správnym nastavením dostanete zo svojho GPU servera maximálnu dravosť a rýchlosť. Vyberte si metódu, ktorá najlepšie sedí vašej prevádzke, a doprajte svojim používateľom bleskové odpovede bez akýchkoľvek kompromisov. Objednávajte tu

 slovenčina
 čeština
 english